
切换主题
01 · FreeRTOS 内存管理:先看懂 MCU 的内存世界
上来就讨论 FreeRTOS 内存管理,可能会稍微有些晦涩。
但如果我们连 MCU 里面到底有哪些内存、CPU 怎么访问这些内存都不知道,就直接开始背
heap_1、heap_2、heap_4,最后很容易变成“会用 API,但是不知道内存到底去了哪里”。所以这一节我们先不着急进入 FreeRTOS,而是从 MCU 本身开始,把 总线 → 总线矩阵 → Memory Map → Flash/SRAM 这一条底层链路建立起来。
陌生的前置知识不用怕,我们一步一步来。
1. 前置知识:总线到底是什么
总线(Bus)暂时可以理解为:
MCU 内部不同模块之间传递信息的通道。
一次典型的总线访问中,我们通常关心三类信息:
- 地址:我要访问哪里?
- 数据:我要读取什么,或者我要写入什么?
- 控制信息:这是一次读操作还是写操作?访问宽度是多少?
例如:
c
uint32_t value;

value = *(uint32_t *)0x20000000;先不用纠结这个指针写法,如果指针基础不熟,可以先把这里理解成:
CPU 想读取地址
0x20000000里面存放的数据。
那么从硬件角度,大致会发生:
text
CPU 发起读取请求
        ↓
地址 = 0x20000000
        ↓
通过 CPU 总线接口发出
        ↓
总线系统根据地址进行译码
        ↓
发现该地址属于 SRAM1
        ↓
请求被送到 SRAM1
        ↓
SRAM1 返回数据
        ↓
CPU 得到 value这里先记住一个很重要的思想:
CPU 访问内存和外设,本质上都是在“访问地址”。
后面我们看到:
c
GPIOA->ODR你会发现它和访问 SRAM 本质上没有想象中那么不同。
2. 为什么又出现了“总线矩阵”
如果 MCU 里面只有 CPU 和一块内存,那么事情其实很简单:
text
CPU
 │
 │
总线
 │
 │
SRAMCPU 想访问 SRAM,就沿着这条总线访问。
但是现代 MCU 里面,能够主动访问系统资源的东西远远不只有 CPU。
例如:
text
CPU

DMA1

DMA2

Ethernet

USB

DMA2D
...这些模块都有可能需要访问:
text
Flash
SRAM
外设
外部存储器
...这时候问题就出现了。
假设:
text
CPU 正在从 Flash 取指令

与此同时

DMA 正在把 ADC 数据搬运到 SRAM如果所有访问都只能挤在一条公共通道上:
text
CPU ──┐
      │
DMA ──┼──→ 一条公共总线 ──→ Flash / SRAM / 外设
      │
USB ──┘那么即使:
text
CPU 想访问 Flash

DMA 想访问 SRAM两个人访问的明明不是同一个资源,却仍然可能因为共享同一条通道而互相等待。
这显然非常浪费性能。
于是 STM32F4 引入了:
Multi-layer AHB Bus Matrix
多层 AHB 总线矩阵。
我们暂时把它想象成一个大型高速交通枢纽:
text
                 Flash
                   ↑
                   │

CPU ───────┐
           │
           ▼
      ┌───────────┐
      │           │
      │ Bus Matrix│────────→ SRAM
      │           │
      └───────────┘
           ▲
           │
DMA ───────┘

                   │
                   ↓
外设它最重要的能力之一就是:
允许多个访问者,在条件允许的情况下,同时访问不同的目标资源。
例如:
text
CPU → Flash

同时

DMA → SRAM这两个事务就有机会并行进行。
所以目前我们可以先这样理解:
总线矩阵 = 管理多个访问发起者与多个目标资源之间连接、路由和冲突仲裁的高速交换中心。
3. Master 和 Slave 到底是什么意思
既然存在访问,就自然存在:
text
谁主动发起访问?

谁被访问?于是总线系统里经常出现两个概念。
Master —— 主设备 / 主接口
能够主动发起一次总线访问。
例如:
text
Cortex-M4

DMA

Ethernet DMA

USB DMA都可能作为 Master。
Slave —— 从设备 / 从接口
负责响应别人发起的访问。
例如:
text
SRAM

Flash

外设寄存器

各种控制器寄存器都可以成为访问目标。
但是这里千万不要形成:
“一个硬件模块天生只能是 Master 或者只能是 Slave。”
这种认知。
实际上一个复杂模块可以同时提供不同性质的接口。
例如 DMA:
CPU 配置 DMA 时:
text
CPU
 ↓
访问 DMA 控制寄存器
 ↓
DMA 的寄存器接口此时 CPU 是访问发起者。
但是 DMA 真正开始搬运数据以后:
text
DMA
 ↓
主动读取外设
 ↓
主动写入 SRAMDMA 自己又成为了总线访问发起者。
所以更加准确地说:
Master / Slave 描述的是总线接口和访问关系,而不是简单给整个硬件模块永久贴一个标签。
4. 开始真正看 STM32F429 的系统架构
现在我们终于可以打开 STM32F429 的参考手册。
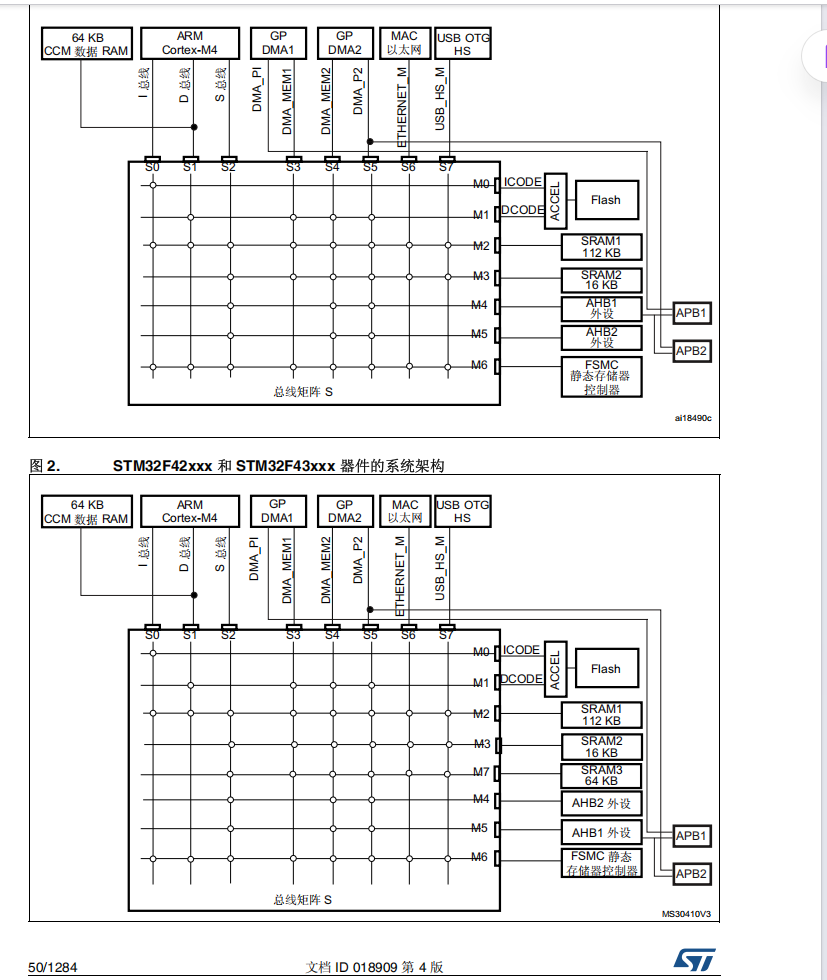
第一次看到这种图,不要试图一根线一根线全部看懂。
先把它分成三个区域:
text
             【访问发起者】

 Cortex-M4   DMA1   DMA2   Ethernet
     │        │      │       │
     └────────┴──────┴───────┘
                  ↓

        ┌────────────────┐
        │                │
        │   Bus Matrix   │
        │                │
        └────────────────┘

                  ↓

              【资源】

Flash / SRAM / AHB外设 / FMC所以整张图最外层的逻辑其实非常简单:
text
谁想访问资源
      ↓
总线矩阵
      ↓
它想访问哪个资源不同 STM32F4 型号拥有的 Master 数量并不完全一样。
例如 STM32F429 相比一些 STM32F407 型号,还拥有 LTDC、DMA2D 等模块,所以不要死记:
“STM32F4 永远有 8 条主控总线、7 条被控总线。”
正确思维应该是:
具体有多少接口,要看当前芯片的数据手册和系统架构图。
5. Cortex-M4 为什么伸出来三条总线
把目光放到:
text
ARM Cortex-M4会发现下面并不是只有一条线,而是:
text
            Cortex-M4
          /      |      \
         /       |       \
I-Bus D-Bus S-Bus这非常重要。
也说明一个需要纠正的认知:
不能理解成“单核 CPU 同一时间只能走一条总线”。
Cortex-M4 内部本身就具有多个用于不同类型访问的总线接口。
5.1 I-Bus:Instruction Bus
I = Instruction。
它主要负责:
取指令。
CPU 想运行一个程序,就必须不断执行:
text
取指令
 ↓
译码
 ↓
执行
 ↓
取下一条指令
 ↓
……假设我们写:
c
int main(void)
{
    HAL_Init();

    while (1)
    {
        LED_ON();
    }
}C 语言经过:
text
编译
 ↓
汇编
 ↓
链接最终会生成 Cortex-M4 能够执行的机器指令。
通常情况下,这些程序代码会存放在:
text
Flash所以 CPU 必须不断从 Flash 中读取下一条机器指令。
经典路径就是:
text
        Cortex-M4
            │
            │ 我要下一条指令
            ↓
          I-Bus
            │
            ↓
           S0
            │
            ○
            │
           M0
            │
          ICODE
            │
     ART Accelerator
            │
Flash这里的:
text
ICODE不要理解成一块新的内存。
它更像是:
Flash 提供给“指令访问”的一条入口。
真正存储程序的仍然是:
text
Flash Memory5.2 D-Bus:Data Bus
D = Data。
D-Bus 主要用于 Cortex-M4 对代码区域中的数据进行访问,例如:
c
const uint32_t table[] =
{
    10,
    20,
    30,
    40
};这样的只读常量通常也可能存放在 Flash。
假设 CPU 正在读取:
c
value = table[0];这时候:
text
地址虽然仍然位于 Flash

但 CPU 不是把它当“指令”读取

而是在进行“数据读取”于是可以经过:
text
Cortex-M4
    │
  D-Bus
    │
   S1
    │
 DCODE
    │
Flash所以同一块 Flash 可以存在:
text
               Flash
              /     \
             /       \
          ICODE     DCODE
            ↑         ↑
            │         │
         I-Bus      D-Bus
            │         │
取指令 读数据另外,Cortex-M4 的 D-Bus 还直接连接到了 CCM Data RAM。
这个我们后面单独讲。
5.3 S-Bus:System Bus
S = System。
System Bus 主要用于访问:
text
SRAM

外设寄存器

AHB / APB 外设

外部存储器例如:
c
GPIOA->ODR |= (1 << 6);GPIOA 是 AHB1 外设。
所以这次访问大致会经过:
text
Cortex-M4
    │
  S-Bus
    │
   Bus Matrix
    │
   AHB1
    │
  GPIOA
    │
ODR再比如普通变量位于 SRAM:
c
uint32_t value = 10;CPU 访问它时也主要通过 System Bus。
需要注意:
S-Bus 不仅能够访问数据和外设,在某些地址区域它同样可以取指令,只不过通常没有专门的 I-Code 路径高效。
所以我们目前可以先记:
text
I-Bus
主要:取指令

D-Bus
主要:访问代码区域中的数据、CCM 等

S-Bus
主要:SRAM 和外设访问不要把它们理解成完全互斥、永远不能访问其他内容的三条死规则。
6. 总线矩阵里的空心圆是什么意思
仔细看 Bus Matrix:
text
S0
 │
 │
○──────── M0你会发现有些十字交叉的位置存在:
text
○有些位置只是两条线交叉,却没有圆。
这里非常关键:
空心圆表示这两个 Bus Matrix 端口之间存在合法的硬件连接。
例如:
text
S0 × M0存在:
text
○说明:
text
S0 → M0存在合法路径。
如果某一个交叉点没有:
text
○则表示:
这两个端口之间没有直接连接关系。
所以看总线矩阵时,可以沿着某一个 Master 的竖线一路往下找:
text
哪里有 ○
 ↓
说明它能够到达哪些目标端口7. S0、S1 和 M0 到底是什么意思
这里还有一个很容易绕进去的地方。
例如 Cortex-M4:
text
I-Bus → S0

D-Bus → S1

S-Bus → S2你可能会奇怪:
CPU 明明是 Master,为什么连接到一个叫 S0 的东西?
原因是:
S0 / M0 的命名,是站在 Bus Matrix 本身的角度命名的。
例如:
text
CPU Master
    ↓
Bus Matrix 的 Slave Port S0
    ↓
Bus Matrix 内部路由
    ↓
Bus Matrix 的 Master Port M0
    ↓
Flash Slave所以:
text
CPU 是 Master和:
text
它连接 Bus Matrix 的 S0并不矛盾。
只是观察角度不同。
初学阶段如果觉得这个术语比较绕,也不用死记,只需要能沿着:
text
CPU → Sx → ○ → Mx → 资源找到访问路径即可。
8. 如果两个 Master 同时访问一个资源怎么办
前面说:
text
CPU → Flash

DMA → SRAM由于访问目标不同,它们有机会并行工作。
但是如果:
text
CPU
 │
 ├────→ SRAM1
 │
DMACPU 和 DMA 同时想访问 SRAM1 呢?
这时候就出现了:
Bus Arbitration
总线仲裁。
可以先理解成:
text
CPU ─────┐
         │
         ▼
      仲裁器
         │
         ▼
       SRAM1
         ▲
         │
DMA ─────┘总线系统需要决定:
当前这次访问先让谁通过?
被选中的访问先进行。
没有获得访问权的一方需要等待。
需要注意,这和我们之前学 I²C 时的“仲裁”在思想上有相似之处:
都是在发生资源冲突时决定谁能够继续。
但两者具体硬件机制完全不同,不要直接把它们理解成同一套协议。
另外,也不要简单理解成:
“高优先级设备一旦获得总线,就必须把所有事情全部干完以后其他人才能访问。”
真正的仲裁会结合:
text
目标 Slave
访问事务
Burst
Bus Matrix 的仲裁策略等因素决定。
现在我们只需要建立:
多个 Master 同时访问同一个 Slave → 会产生竞争 → 需要仲裁。
这个模型就够了。
9. CPU 的“取指—译码—执行”到底发生了什么
这里把一个容易写错的地方单独拿出来。
CPU 最核心的工作循环可以简化为:
text
Fetch
取指
 ↓
Decode
译码
 ↓
Execute
执行取指阶段:
text
CPU
 ↓
I-Bus
 ↓
读取机器指令译码阶段:
text
机器指令
 ↓
Cortex-M4 内核内部译码器
 ↓
识别这是 ADD、LDR、STR……执行阶段:
可能由:
text
ALU

寄存器

FPU

Load/Store Unit等内核单元完成。
因此不能写成:
“执行阶段通过 D-Bus 完成。”
只有当执行的这条指令需要访问内存数据时,才可能进一步通过:
text
D-Bus

或者

S-Bus发起数据访问。
例如:
c
a = b + c;如果 b、c 已经在 CPU 寄存器中:
text
CPU ALU直接计算甚至根本不需要额外访问总线。
10. 一个比较特殊的存在:CCM RAM
仔细看系统架构图,还会发现:
text
64 KB
CCM Data RAM它的位置非常特殊。
它不像普通 SRAM1 / SRAM2 / SRAM3 那样挂在 Bus Matrix 的右侧。
而是直接与 Cortex-M4 的 D-Bus 联系得非常紧密。
CCM:
Core Coupled Memory
内核耦合存储器。
可以先把它理解成:
为了给 CPU 提供快速数据访问,而专门贴近 CPU 内核设计的一块 RAM。
这同时带来了一个非常重要的特点:
普通 DMA 不能像访问 SRAM1 那样访问 CCM RAM。
所以以后我们真正进入工程以后,会遇到:
text
为什么 DMA Buffer 不能随便放 CCM?

任务栈能不能放 CCM?

FreeRTOS Heap 能不能放 CCM?

高速算法变量放 CCM 有没有好处?这些问题。
现在先把这个伏笔留下。
11. Memory Map:地址到底是怎么找到硬件的
理解完总线以后,接下来终于可以讨论:
CPU 到底怎么知道
0x20000000是 SRAM?
答案就是:
Memory Map
存储器映射。
STM32F429 使用的是 32 位 Cortex-M4。
所以 CPU 地址宽度为:
text
32 bit能够表示:
text
0x00000000

到

0xFFFFFFFF总共有:
text
2^32 Byte也就是:
text
4 GB 地址空间这里非常容易犯一个错误。
这并不是说:
STM32F429 内部真的拥有 4GB RAM。
而是:
CPU 理论上能够产生 4GB 范围内的不同地址。
然后 ARM 和 ST 会把这个巨大的地址空间切成很多区域:
text
某一段地址 → Flash

某一段地址 → SRAM

某一段地址 → GPIO

某一段地址 → USART

某一段地址 → Cortex-M4 内部系统资源这就是:
Memory Mapping。
12. 地址只是“门牌号”
例如:
text
0x20000000并不是 SRAM1 本身。
它只是:
CPU 地址空间中的一个门牌号。
ST 的硬件地址译码逻辑规定:
text
0x20000000
      ↓
映射到
      ↓
SRAM1所以 CPU 发出:
text
READ 0x20000000硬件发现:
text
这个地址属于 SRAM1于是访问被送到 SRAM1。
整个过程:
text
CPU
 │
 │ address = 0x20000000
 ↓
S-Bus
 │
 ↓
Bus Matrix
 │
 │ 地址译码
 ↓
SRAM113. STM32F429 中几个目前最值得记的地址
我们现在完全没有必要背完整 Memory Map。
先认识几个以后经常出现的区域。
text
0x08000000
    ↓
Flash Memory 起始地址


0x10000000
    ↓
64 KB CCM Data RAM


0x20000000
    ↓
SRAM1
112 KB


0x2001C000
    ↓
SRAM2
16 KB


0x20020000
    ↓
SRAM3
64 KB


0x40000000 ...
    ↓
外设地址区域其中:
text
SRAM1
0x20000000 ~ 0x2001BFFF

SRAM2
0x2001C000 ~ 0x2001FFFF

SRAM3
0x20020000 ~ 0x2002FFFFSTM32F429 比我们前面经常使用的某些 STM32F407 型号还多了一块 SRAM3。
因此这里再次提醒:
不同 MCU 的内存容量和具体组织形式会变化,学习 Memory Map 时必须以当前芯片的数据手册为准。
但是底层思想基本是一致的。
14. 怎么阅读 Memory Map 表格
例如我们可能看到:
text
0xA0000000 ~ 0xA0000FFF对应 FMC/FSMC 的某些控制寄存器区域。
这是什么意思?
不是说:
“这里真的摆了一块叫 0xA0000000 的内存。”
而是 CPU 如果访问:
text
0xA000xxxx地址译码逻辑会把这次访问:
text
送到 FMC/FSMC 对应的控制器所以:
text
访问一个地址

本质上

就是在访问这个地址映射到的硬件资源15. 再来看 RNG 的例子
例如:
text
0x50060800 ~ 0x50060BFF被分配给:
text
RNG
随机数发生器那么:
text
CPU访问 0x500608xx硬件地址译码以后:
text
请求会被送到 RNG 外设所以我们可以说:
这段地址是 RNG 的寄存器地址空间。
这里需要特别注意:
text
0x50060800并不属于:
text
0xE0000000 ~ 0xFFFFFFFF的 Cortex/System 内部资源区域。
RNG 在 STM32F429 中属于:
text
AHB2 外设所以不要仅仅看到一个很大的十六进制地址,就判断它属于 System 区域。
最终仍然要看 Memory Map。
16. 把 GPIOA->ODR 和总线矩阵连接起来
现在重新看我们以前每天都在写的一句话:
c
GPIOA->ODR |= (1 << 6);以前可能只知道:
“这是在操作 GPIOA 的 ODR 寄存器。”
现在可以往底层继续追。
GPIOA 的基地址位于:
text
0x40020000于是访问:
c
GPIOA->ODR最终其实会变成:
text
CPU执行 Store / Load 指令
        ↓
产生 0x4002xxxx 地址
        ↓
Cortex-M4 System Bus
        ↓
Bus Matrix
        ↓
地址译码
        ↓
AHB1 Peripheral
        ↓
GPIOA
        ↓
ODR 寄存器也就是说:
text
一行 C 代码

      ↓

CPU 指令

      ↓

32 位地址

      ↓

Memory Map

      ↓

Bus Matrix

      ↓

真实硬件这条链非常重要。
以后我们学习寄存器、DMA、FreeRTOS、MPU,甚至 Cache 时都会重新遇到它。
17. 地址决定了“访问谁”,那从哪条 Bus 走?
这里把目前学过的东西串起来。
CPU 发起一次访问时,我们可以先问两个问题:
text
① CPU 正在干什么?

② 它访问的是什么地址?例如:
text
PC = 0x08001234CPU 当前在执行:
Instruction Fetch
同时地址:
text
0x08001234属于 Flash Code 区域。
那么典型访问路径是:
text
Cortex-M4
 ↓
I-Bus
 ↓
ICODE
 ↓
Flash但如果:
c
value = *(uint32_t *)0x08001234;虽然地址还是:
text
0x08001234但是这一次 CPU 把它当作:
数据
来读取。
那么可以通过:
text
D-Bus
 ↓
DCODE
 ↓
Flash所以不能简单说:
“地址单独决定 CPU 使用哪条总线。”
更加准确的是:
地址决定目标资源,而访问类型和地址区域共同影响 Cortex-M4 从哪条总线接口发起这次访问。
18. Memory Remap:重映射不是“搬家”
接下来会遇到一个很容易让人迷惑的东西:
Memory Remap
内存重映射。
“重映射”这个名字很容易让人误以为:
text
Flash 原来在 0x08000000

重映射以后

Flash 被搬去了 0x00000000这是错误的。
真正发生变化的是:
CPU 地址和物理存储器之间的映射关系。
物理 Flash 根本没有搬家。
例如正常情况下:
text
0x08000000
      ↓
Flash这条映射仍然存在。
与此同时,STM32 可以让:
text
0x00000000这个启动区域也指向 Flash。
于是:
text
CPU 地址

0x00000000 ──────┐
                 │
                 ├────→ 同一块物理 Flash
                 │
0x08000000 ──────┘也就是说:
同一块物理存储器可以通过不同地址被访问。
这种额外地址也可以理解成:
Alias
别名地址。
19. 为什么需要重映射
Cortex-M4 复位启动以后,需要首先读取:
text
0x00000000

0x00000004附近的启动信息。
其中包含:
text
初始 MSP

Reset_Handler 地址也就是启动时非常重要的:
中断向量表。
但是 STM32 又支持不同启动来源。
例如:
text
Main Flash

System Memory

SRAM如果 Cortex-M4 每种启动方式都要记不同地址,会非常麻烦。
于是 ST 做了一层映射:
text
                       Flash
                         ↑
                         │
0x00000000 ─────→【地址映射选择】
                         │
                         ↓
                  System Memory

                         │
                         ↓
SRAMCPU 仍然从:
text
0x00000000寻找启动信息。
至于:
text
0x00000000当前到底对应 Flash、System Memory 还是 SRAM,由 STM32 的启动和重映射配置决定。
最关键的是:
被映射的存储器原来的地址并不会消失。
例如 SRAM 被映射到:
text
0x00000000以后:
text
0x20000000仍然可以正常访问 SRAM。
只是多了一个能够访问同一物理资源的地址入口。
20. 为什么总线矩阵里的 I-Bus 能连接 SRAM
现在重新回头看系统架构图。
我们曾经发现:
text
I-Bus / S0居然存在连接:
text
○ → SRAM当时会很疑惑:
I-Bus 不是取 Flash 指令的吗?
为什么还能去 SRAM?
现在就能理解了。
因为:
SRAM 中同样可以存放并执行代码。
并且在某些 Boot / Remap 场景下,SRAM 可以映射到 Code 区域。
于是:
text
CPU
 ↓
I-Bus
 ↓
Bus Matrix
 ↓
SRAM这条硬件路径就有存在的意义。
所以总线矩阵里的:
text
○告诉我们的只是:
硬件存在这条合法通路。
而:
text
Memory Map / Remap决定:
某个地址当前究竟会被送到哪个资源。
这两个概念千万不要混在一起。
21. Flash Memory 和 Flash Interface 不是同一个东西
查看 Memory Map 时还有一个特别容易懵的地方。
可能会发现手册里面出现:
text
Flash Interface于是产生疑问:
“不是说 Flash 在 0x08000000 吗?”
“为什么这里又出现一个 Flash Interface?”
原因是:
text
Flash Memory

和

Flash Interface完全不是同一个概念。
21.1 Flash Memory
Flash Memory 是:
真正用于保存程序代码、常量等内容的非易失性存储器。
它的正常映射起始地址是:
text
0x08000000例如 CPU 的:
text
PC = 0x08001234意味着 CPU 正准备执行 Flash 中这个地址附近的程序代码。
21.2 Flash Interface
Flash 并不像 SRAM 一样可以随随便便直接改写。
Flash 存在:
text
擦除

编程

等待周期

Cache

Prefetch

读保护

写保护等复杂操作。
所以 STM32 内部专门设计了:
Embedded Flash Memory Interface
我们可以把它暂时理解成:
Flash 的管理控制器。
里面存在:
text
FLASH_ACR

FLASH_KEYR

FLASH_SR

FLASH_CR
...这些控制寄存器。
CPU 可以通过这些寄存器完成:
text
解锁 Flash

设置等待周期

启动 Sector 擦除

Flash 编程

查询 Busy

配置 Cache

开启 Prefetch所以整个关系应该理解成:
text
CPU
 │
 │ 读取程序
 ↓
Flash Interface / ICODE/DCODE
 │
 ↓
Flash Memory


CPU
 │
 │ 配置擦写操作
 ↓
Flash Interface 控制寄存器
 │
 ↓
Flash Controller
 │
 ↓
真正操作 Flash Memory因此:
Memory Map 中看到的 Flash Interface,往往是在描述 Flash 控制器的寄存器空间。
而:
text
0x08000000描述的是:
真正的 Flash Memory 映射区域。
两者不要混为一谈。
22. 到目前为止,我们应该建立什么模型
这一大段前置知识,不要求一次全部背下来。
真正重要的是脑子里形成下面这条链:
text
C代码

 ↓

CPU机器指令

 ↓

CPU发起访问

 ↓

I-Bus / D-Bus / S-Bus

 ↓

32位地址

 ↓

Memory Map / 地址译码

 ↓

Bus Matrix

 ↓

Flash / SRAM / Peripheral

 ↓

真正的硬件资源再把几个概念分清:
text
Memory Map
回答:
“这个地址代表谁?”


I / D / S Bus
回答:
“Cortex-M4 从哪个接口发起这类访问?”


Bus Matrix
回答:
“这个访问者有没有路能够到目标资源?
如果多人抢同一个资源怎么办?”


Memory Remap
回答:
“某一段 CPU 地址当前被映射到了哪个物理资源?”


Flash Interface
回答:
“Flash Memory 是怎么被管理、擦除和编程的?”

到这里,我们才真正拥有继续讨论:

text
裸机程序的代码放在哪里?

全局变量放在哪里?

局部变量放在哪里?

栈是什么?

堆是什么?

FreeRTOS 的任务栈又是什么?

pvPortMalloc() 到底从哪里拿内存?

这些问题的底层基础。

下一步,我们正式从:

> **一个普通裸机程序编译完成以后,Flash 和 SRAM 到底被分成了哪些区域?**

开始继续往 FreeRTOS 内存管理靠近。